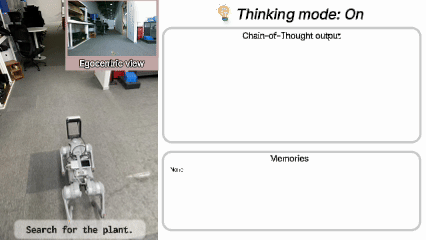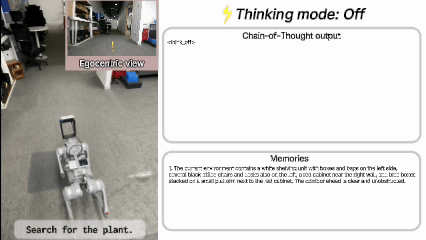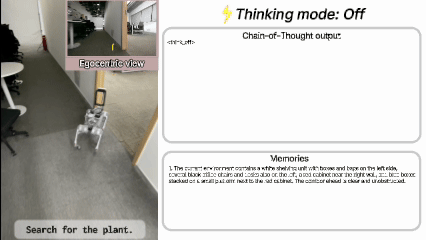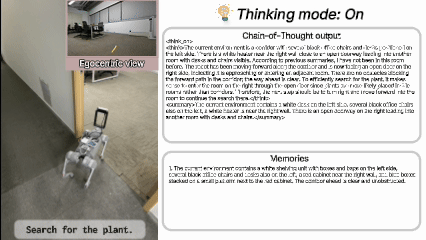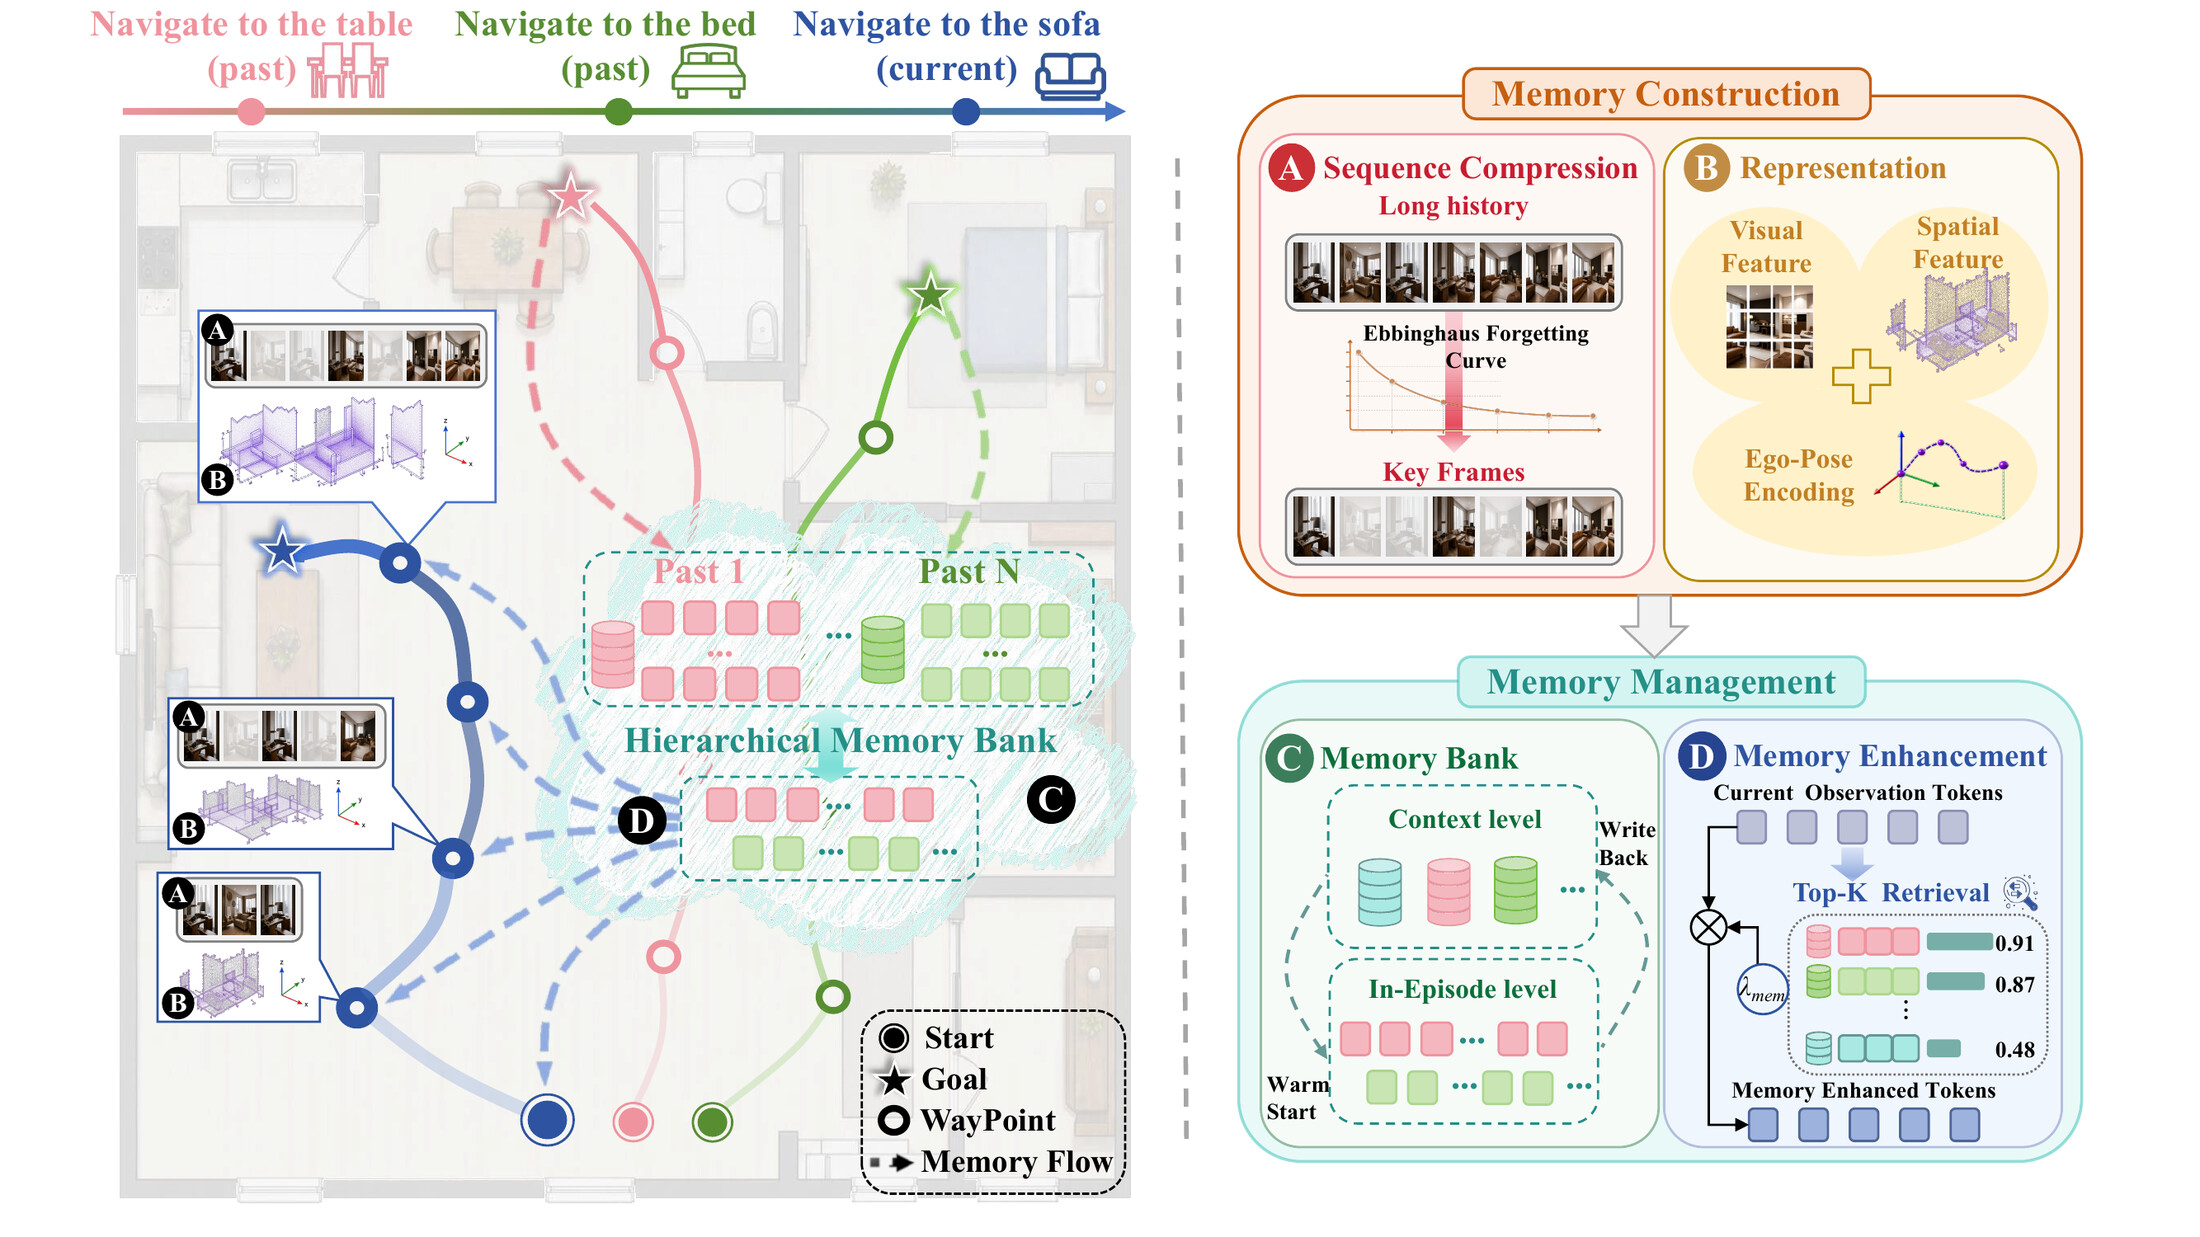
arXiv 2026MemoryVLN: From Ego-Aware Memory Representation to Cross-Context Memory Reuse in Vision-Language NavigationXueyao Wei, Yifei Wang, Delun Li, Shaoan Wang, Junzhi Yu, Wenjie Song, Xingyu ChenMemoryVLN combines compressed ego-aware visuospatial memories with hierarchical retrieval and cross-context reuse for long-horizon vision-language navigation.PDFProjectCode
arXiv 2026Interactive Navigation Beyond Reachability: Benchmark and Agentic FrameworkDelun Li, Xueyao Wei, Rui Chen, Yifei Wang, Junzhi Yu, Wenjie Song, Xingyu ChenMultINav introduces a benchmark and a persistent interaction-graph agent for navigation through interactions that change spatial connectivity and target visibility.PDFProjectCode
arXiv 2026PINT: A Unified Model with Shared Predictive Intent for Robot ManipulationXingyu Guo, Chao Jing, Li Yi, Xingyu Chen, Zhengxing WuPINT is a unified model with shared predictive intent for robot manipulation.PDFProjectCode
arXiv 20264D Latent Cache for Efficient Conditioning in Dynamic World ModelingJianhui Zhang, Zuyao Lin, Pengxin Xu, Jingdong Wang, Xingyu Chen4LC reuses cached visual representations across time and viewpoints to condition multi-task video generation efficiently.PDFProjectCodeDemo
NeurIPS 2026HyrCAP: Hybrid Rank-Calibration of Action Proposals for Temporal Event UnderstandingRui Chen, Xingyu Chen, Pengxin Xu, Kai Chen, Junzhi YuHybrid propose rank-calibration method for of action proposal and semantic understanding.PDFProjectCode
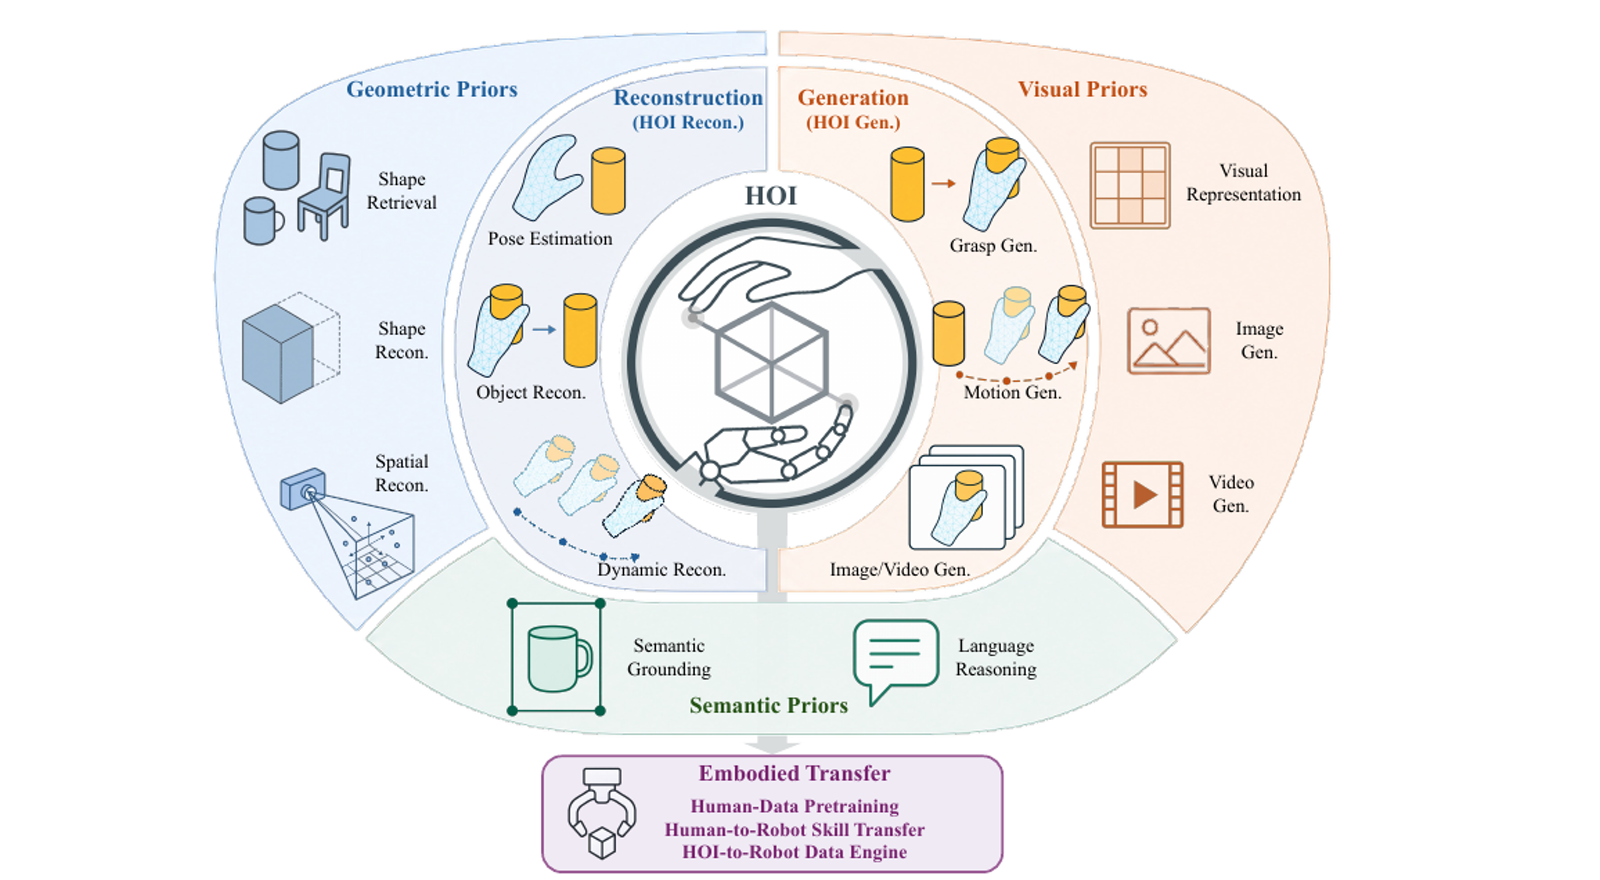
arXiv 2026Hand-Object Interaction in the Age of Large Foundation Models: Reconstruction, Generation, and Embodied TransferWeiquan Lin, Yu Deng, Shiyang Liu, Luping Xiao, Xu Tang, Junzhi Yu, Jiaolong Yang, Lei Zhang, Xingyu ChenA systematic survey of foundation-model priors for hand-object interaction across reconstruction, generation, and embodied transfer.PDFProjectCode
NeurIPS 2026PriorVLA: Prior-Preserving Adaptation for Vision-Language-Action ModelsXinyu Guo, Bin Xie, Wei Chai, Xianchi Deng, Tiancai Wang, Zhengxing Wu, Xingyu ChenPrior knowledge maintenance and efficient downstream fine-tuning in VLA models.PDFProject
arXiv 2026World-Ego Modeling for Embodied Video Generation in Long-Horizon Navigation-Manipulation TasksZuyao Lin, Jianhui Zhang, Peidong Jia, Xiaoguang Zhao, Shanghang Zhang, Jingdong Wang, Xingyu ChenA video-based world-ego modeling framework for long-horizon evolution in hybrid embodied tasks.PDFProject
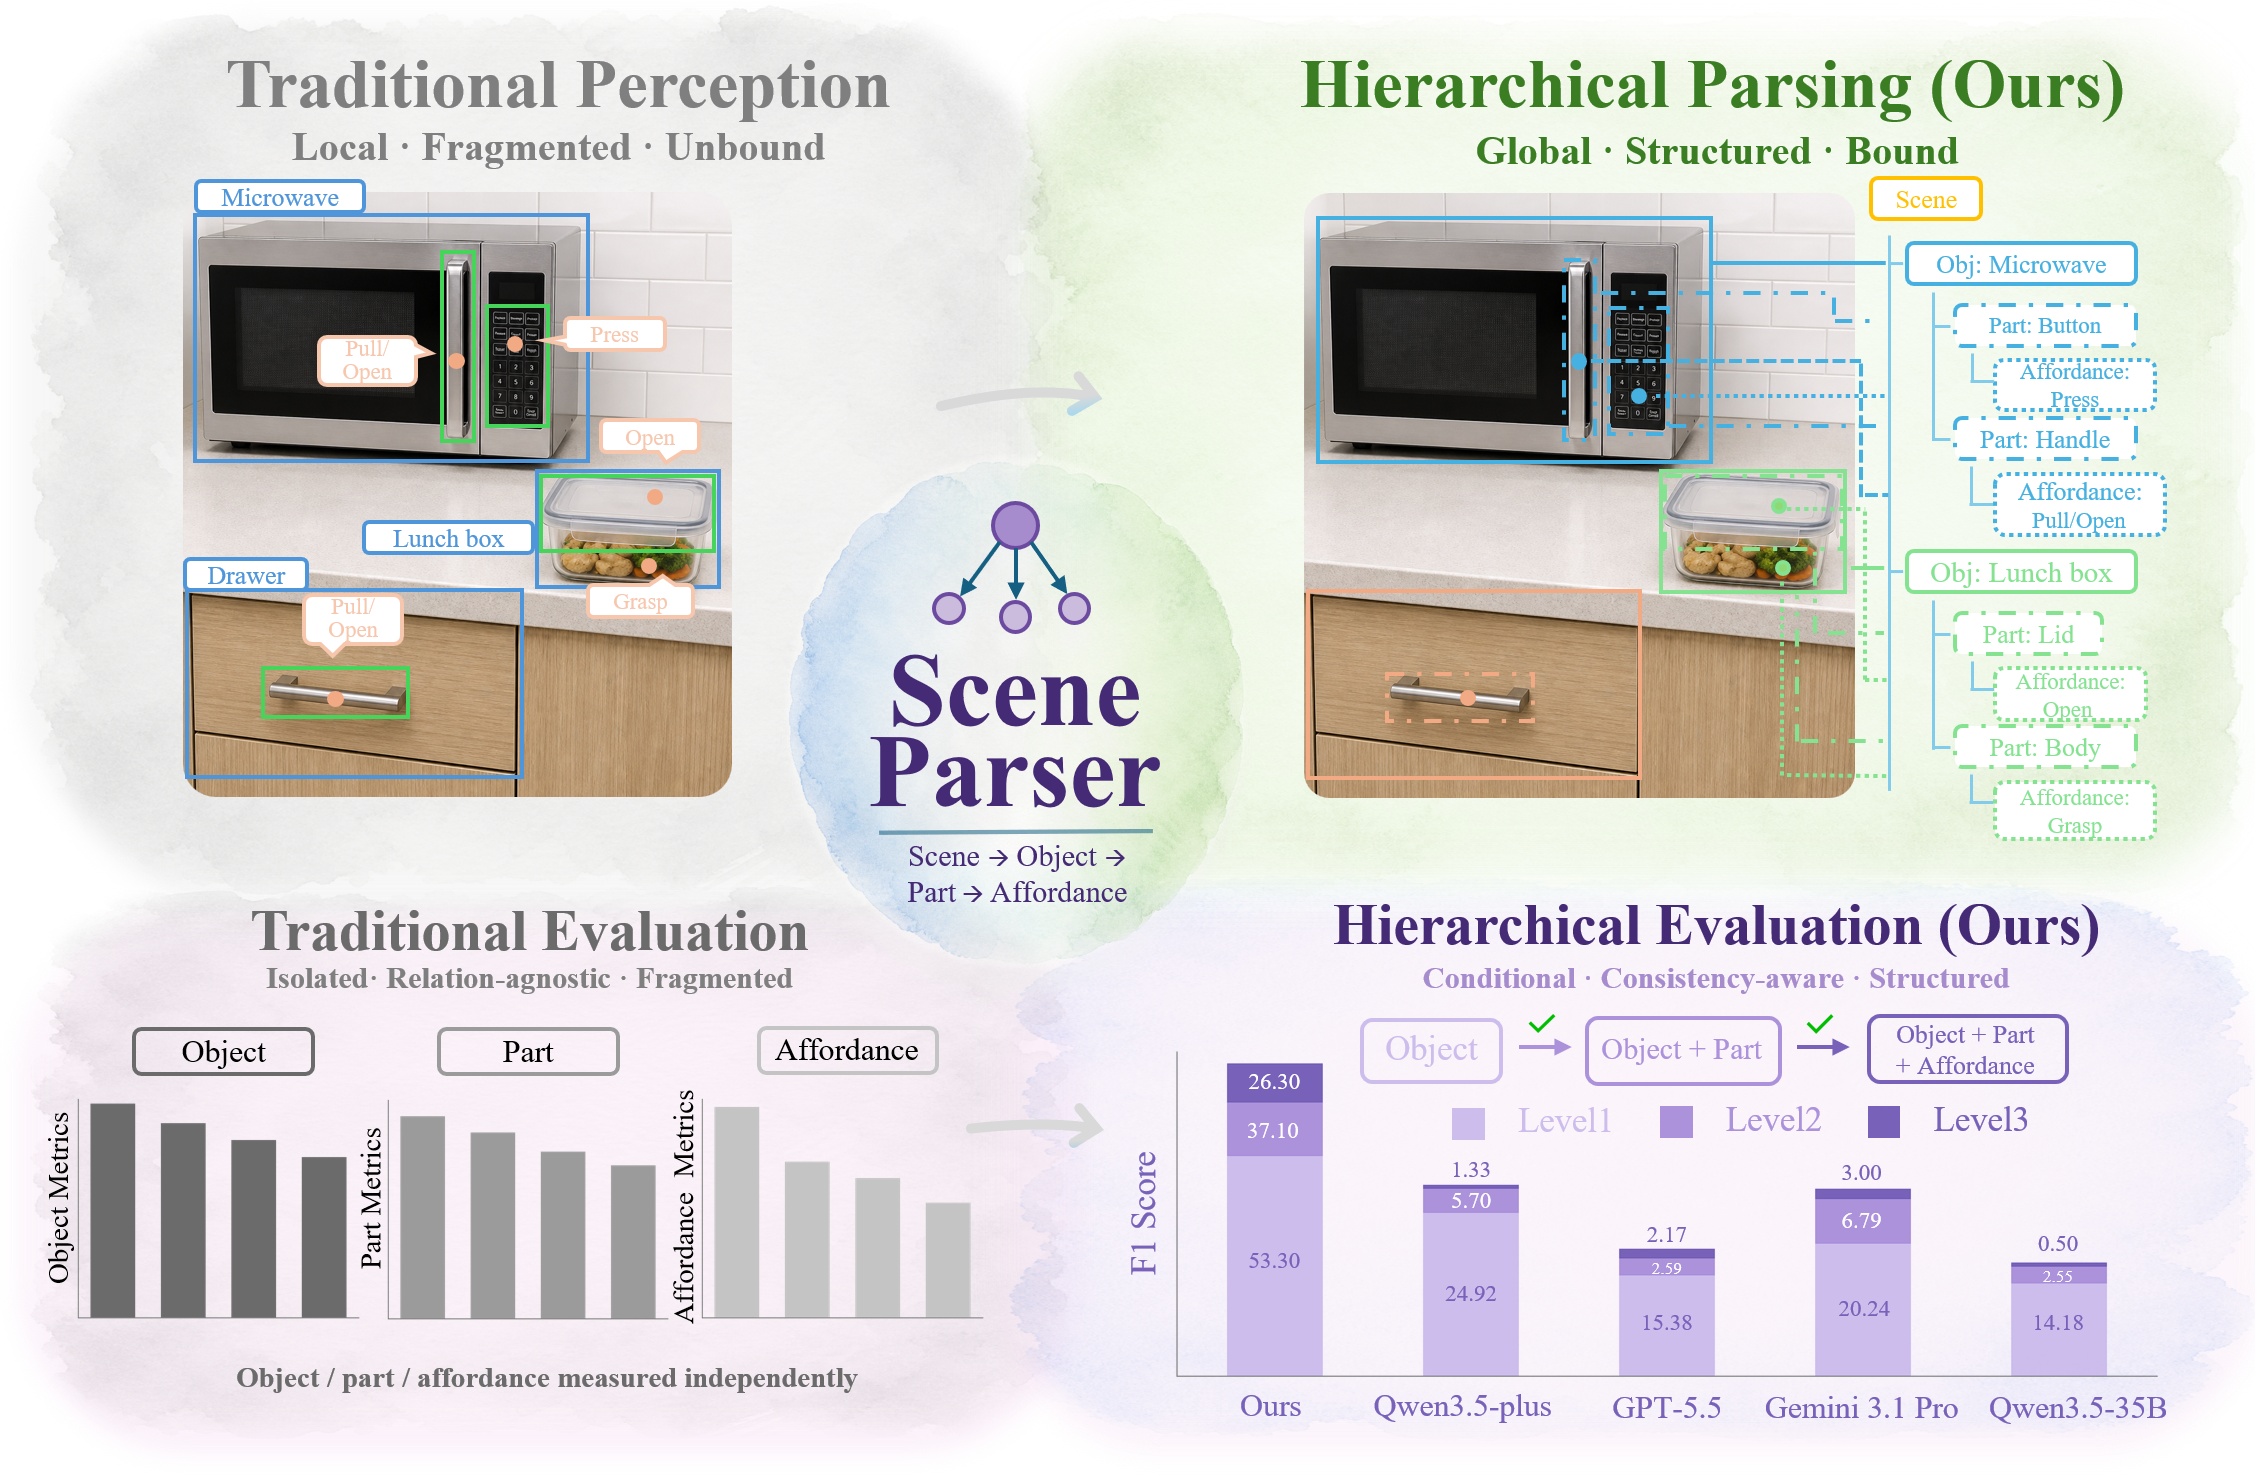
arXiv 2026SceneParser: Hierarchical Scene Parsing for Visual Semantics UnderstandingPengxin Xu, Xincheng Lin, Luping Xiao, Qing Jiang, Meishan Zhang, Hao Fei, Shanghang Zhang, Xingyu ChenA hierarchical scene parsing framework for comprehensive visual semantic understanding.PDFCode
ACM MM 2026GeoHand: Unlocking Prior Geometry Knowledge for Monocular 3D Hand ReconstructionWeiquan Lin, Yaoqing Hu, Liangchen Dai, Xu Tang, Xingyu ChenGeoHand leverages prior geometry knowledge for monocular 3D hand reconstruction.PDF
TRO 2026VLingNav: Embodied Navigation with Adaptive Reasoning and Visual-Assisted Linguistic MemoryShaoan Wang, Yuanfei Luo, Xingyu Chen, Aocheng Luo, Dongyue Li, Chang Liu, Sheng Chen, Yangang Zhang, Junzhi YuVLingNav combines adaptive reasoning with visual-assisted linguistic memory for persistent cross-modal semantic memory in long-horizon navigation.PDFProject